メインコンテンツまでスキップ

参加者​

  • PMS: 武田様、山森様、宮森様
  • WEBRAL: 戸張、寺井

議題​

  1. 前回の決定事項やTODO
  2. 検証結果
  3. 全身写真のラベリングについて
  4. おすすめの事務所について

1. 前回の決定事項やTODO​

決定事項​

採点ロジックを一部見直しつつ、引き続き学習データを増やして検証。

TODO​

  • 顔立ちの部分も減点方式に統一する
  • グラフの部分の単位をポイントにして、「合計:111点 / 130点」の130点の部分を100点換算で表記する
  • 150件でモデル作り直し&採点
  • 目の形を3つに減らす。
  • 吊り目と垂れ目を抽出して、送る。(ラベリングし直してもらう)

2. 検証結果​

◼︎ SpreadSheet​

https://docs.google.com/spreadsheets/d/1WGbnQb63f4uvGJ2anzs2IgbcWxGZ1dUGbaKR8lJLGLY/edit?usp=sharing

◼︎ 全体感​

データに偏りがある&クラス(分類)の数が少ない項目は正答率(Accuracy)が高くなる傾向にあります。(例:目の特徴など)

◼︎ 対策​

学習用データの少ないクラス(分類)のデータ量を増やす。 鼻の大きさであれば「小さい」のラベルのデータ量を増やす。 具体的には、各ラベル100枚分くらいまでにデータ量を増やす。

もし応募者の画像で足りなければ、フリー素材のデータセットを利用するなど。

https://www.kaggle.com/datasets/yewtsing/pretty-face https://www.kaggle.com/datasets/ciplab/real-and-fake-face-detection

・Accuracy
全クラス(分類)に対する予測精度の値(データ数の大きいクラスに対する予測精度の影響を受けやすい)

・Precision
ある一つのクラス(分類)に対する予測精度の値


3. 全身写真のラベリングについて​

前々回(2023年5月)の打ち合わせで、「脚の長さ」や「膝下の長さ」や「手の長さ」など全身写真のラベリングの正答率が上がりにくいという話がありました。 対応策として、全身写真の分類をやめて、すでに学習済みの全身の骨格を取得できる機械学習モデルを試してみるという案が出ました。

使ってみた結果​


4. おすすめの事務所について​

  • ファッションモデル系モデル事務所 => 19件
  • コマーシャルモデル系モデル事務所 => 31件

◼︎「あなたにおすすめのモデル事務所」の選定フロー​

  1. 応募者のラベルを元にコマーシャルモデルとしての点数とファッションモデルとしての点数を算出(採点表を元に)
  2. 8つのモデルカテゴリーの中から、応募者のレーダーチャートと最も形の近いモデルカテゴリーを一つ抽出(相関係数の高いものを一つ抽出) = 「あなたにおすすめのモデルカテゴリー」
  3. コマーシャルモデルかファッションモデルかを判定
  4. コマーシャルモデルだったら、コマーシャルモデル系のモデル事務所を全て抽出。ファッションモデルだったら、ファッションモデル系のモデル事務所を全て抽出。
  5. 抽出したモデル事務所の中から、応募者のレーダーチャートと形の近い(相関係数の高い)事務所順に並べる = 「あなたにおすすめのモデル事務所」

5. 本日の決定事項やTODO​

  • 各事務所のレーダーチャートをエクスポートして渡す
  • 足を開いて写真を撮ってみる
  • データ数が少ないラベルはどれか?を山森さんに送る

参加者​

武田様、山森様、宮森様、戸張

議題​

  1. 採点方法について
  2. 本日の決定事項やTODO

1. 前回の議論​

顔立ちと鼻が低く採点されやすい


3. 本日の決定事項やTODO​

  • 顔立ちの部分も減点方式に統一する
  • グラフの部分の単位をポイントにして、「合計:111点 / 130点」の130点の部分を100点換算で表記する
  • 150件でモデル作り直し&採点
  • 目の形を3つに減らす。
  • 吊り目と垂れ目を抽出して、送る。(ラベリングし直してもらう)
  • 見積もり送る
  • 2023年中にあと2〜3回打ち合わせして結果を見る

参加者​

武田様、山森様、宮森様、戸張

議題​

  1. 前回の議論
  2. 【運用について】推論の精度を高めるために
  3. 本日の決定事項やTODO

1. 前回の議論​

推論精度(正答率)の低い機械学習モデルについて、以下の対応を行った。

  1. 学習用のデータを増やす
  2. 学習用画像データセットの改善
    1. 学習に使用する画像を統一(撮影場所、撮影角度、服装など)
    2. 顔周りだけをトリミング
  3. 機械学習モデルの分割
    1. 先天的要因を以下の機械学習モデルに分割。
      1. 顎あり顎なし
      2. 斜視ありなし
      3. 三白眼か否か
      4. 顔が左右非対称か否か
      5. 骨盤に張りがあるか否か

結果、正答率が10〜30%台から、50〜70%台に向上した。

引き続き、精度が低いままである機械学習モデルについて、上機と同様の対応を行う。


2. 改善施策​

データ量が増えたことで精度(正答率)が向上したものもあれば、ほぼ変化ないものもありました。 また、以下の精度の低い複数選択の項目を単一選択にし、分解しました。

  • 肌質
  • 脚のバランス
  • 鼻の形(正面)
  • 鼻の形(横向き)
  • 笑顔の形

結果、トリミングが可能であるバストアップ写真や笑顔写真については大幅に正答率が向上。

ただし、選択肢に偏りがあるものは、確かに90%近くマークしたものの、選択肢に偏りがないもの(顔の左右対称性など)は精度にまだバラツキがある。


3. 本日の決定事項やTODO​

  • 正答率以外に、特異度(実際に負であるもののうち,負であると予測されたものの割合)を算出
  • 全身を測定できる機械学習モデルをリサーチして試してみる
  • 顔立ちの採点方式を修正

参加者​

武田様、山森様、宮森様、戸張

議題​

  1. 前回の議論
  2. 【運用について】推論の精度を高めるために
  3. 本日の決定事項やTODO

1. 前回の議論​

山森さんによる採点結果と機械学習による採点結果で乖離がある。 特に「顔立ち」の乖離が大きい。

  • [要因]
    • 顔立ちの項目は加点方式のため、精度がよほど高くないと点数が上がりづらいのと、特に「先天的要因」による減点が目立つ
    • そもそもの「先天的要因」の推論精度が低い?
  • [対応]
    • データ量(応募者の写真)を増やし精度を高めていく
    • その前にまずは現状の精度(正答率)を計測する(←今ここ)

2. 【運用について】推論の精度を高めるために​

2-1. 【前回の振り返り】運用フロー​

  • どれくらいデータを増やせばよいのか?
    • →学習曲線を用いて精度を管理していく
  • 機械学習モデルの性能をどう高めていくのか?
    • →以下に具体的な流れ
      1. データ準備
        • 1.写真撮影&2.フォルダ分け&3.画像加工
      2. モデル作成(Lobeで自動化)
        • トレーニング&モデル検証
      3. サービス運用(GCPで自動化)
        • サーバーへデプロイ&運用&監視
  • そもそも性能を評価するにはどうするのか?
    • →正答率を用いる
  • どういった流れで管理していくのか
    • →最初はスプレッドシートとフォルダ管理。後々独自システム化。

2-2. 改善施策​

  1. 随時データ量を増やしていく
  2. 学習用画像データセットの改善
    1. 学習に使用する画像を統一(撮影場所、撮影角度、服装など)
  3. 機械学習モデルの分割
    1. 先天的要因を以下の機械学習モデルに分割。
      1. 顎あり顎なし
      2. 斜視ありなし
      3. 三白眼か否か
      4. 顔が左右非対称か否か
      5. 骨盤に張りがあるか否か
    2. 全機械学習モデルの学習用データにおいて、全身写真以外のバストアップ写真を全て顔だけを切り抜き再トレーニング

2-3. 今後の作業内容​

  • 新しいデータ(応募者写真)に対して
    • プロモデルスタジオ様
      • 写真撮影
      • ラベリング作業(フォルダに仕分け)
    • WEBRAL
      • トリミング作業(Google Cloud Vision APIで自動化)
  • 既存データに対して
    • WEBRAL
      • 既存写真のトリミング後、再トレーニング
      • 機械学習モデルの追加

2-4. 今後のスケジュールについて​

  • 納品(受け入れテスト、操作方法レクチャー)
  • 運用フェーズ

3. 本日の決定事項やTODO​

  • 次回打ち合わせ4月10日(月)14時
    • 既存写真のトリミング後、再トレーニング
    • 機械学習モデルの分解

参加者​

武田様、山森様、宮森様、戸張

議題​

  1. 前回の議論
  2. 機械学習モデルの継続的な改善に向けた提案
  3. 本日の決定事項やTODO

1. 前回の議論​

全体的に山森さんの採点と機械学習による採点結果で乖離があり、特に「顔立ち」の採点結果が乖離が大きく、機械学習では低い点数が出てしまう問題

  • [要因]
    • 加点方式のため点数が上がりづらく、また「先天的要因」による減点が目立つ
    • そもそも推論の精度が低い?
  • [対応]
    • 機械学習モデルのデータ量を増やし精度を高める
    • 「顔立ち」に関する採点方法の見直し

2. 機械学習モデルの継続的な改善に向けた提案​

  • どれくらいデータを増やせばよいのか?
  • 機械学習モデルの性能をどう高めていくのか?
  • そもそも性能を評価するにはどうするのか?
  • どういった流れで管理していくのか

についてのご説明と運用管理に関するご提案です。

2-1. モデル診断カルテで利用している機械学習モデルについて​

Lobeを用いて生成した独自の機械学習モデルが約20個、稼働しています。

2-2. 機械学習モデルの一般的なライフサイクル​

一般的に以下の1〜3のサイクルを繰り返し、モデルの性能を高め、管理します。

  1. データ準備
  2. モデル作成
    1. トレーニング
    2. モデル検証(評価)
  3. サービス運用
    1. サーバーへデプロイ
    2. 運用
    3. 監視

2-3. 機械学習モデルの性能評価の指標​

運用している機械学習モデルのその時点での性能を判断するのに用いる指標には、精度(正解率)、適合率、再現率などがありますが、真かどうかを正確に判断したい場合に使える**精度(正解率)**により評価を行います。

例)目のタイプを分類する機械学習モデルの性能評価

例えば20件の検証用画像を予め人の目で分類し、その後機械学習モデルで推論を行い、それぞれの結果を比較します。答えが一致した件数が18件であれば、正答率は18/20×100=90%となります。

2-4. 必要なデータ数について​

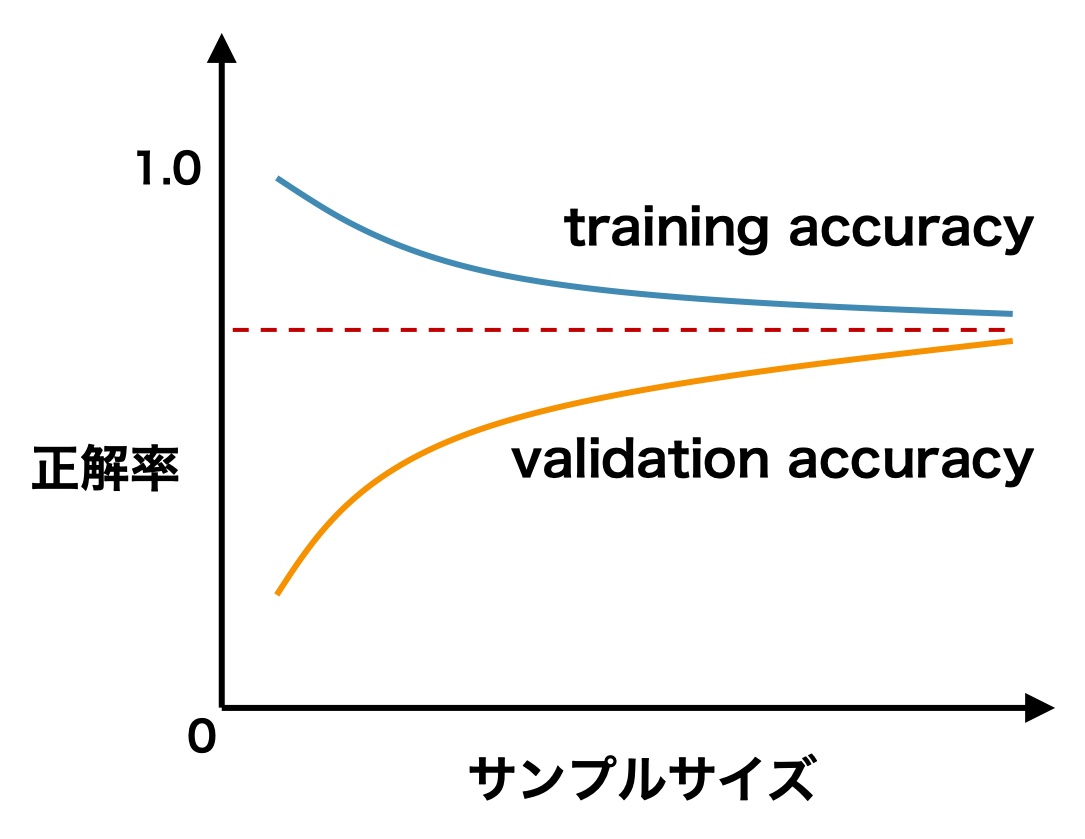
トレーニング用データを増やすことでモデルの性能を高めることが可能ですが、一方でどれほどの数のデータを増やせばいいのかはモデルにより様々であり、改善の余地があるのか?逆にこれ以上データを増やして性能は上がるのか?などを判断するのに役立つのが学習曲線です。

学習曲線は、縦軸に正答率、横軸にデータ数(サンプルサイズ)を取ります。

  • 学習曲線

学習曲線

training accuracyは、トレーニングデータの推論精度。validation accuracyは、未知データに対する推論精度。

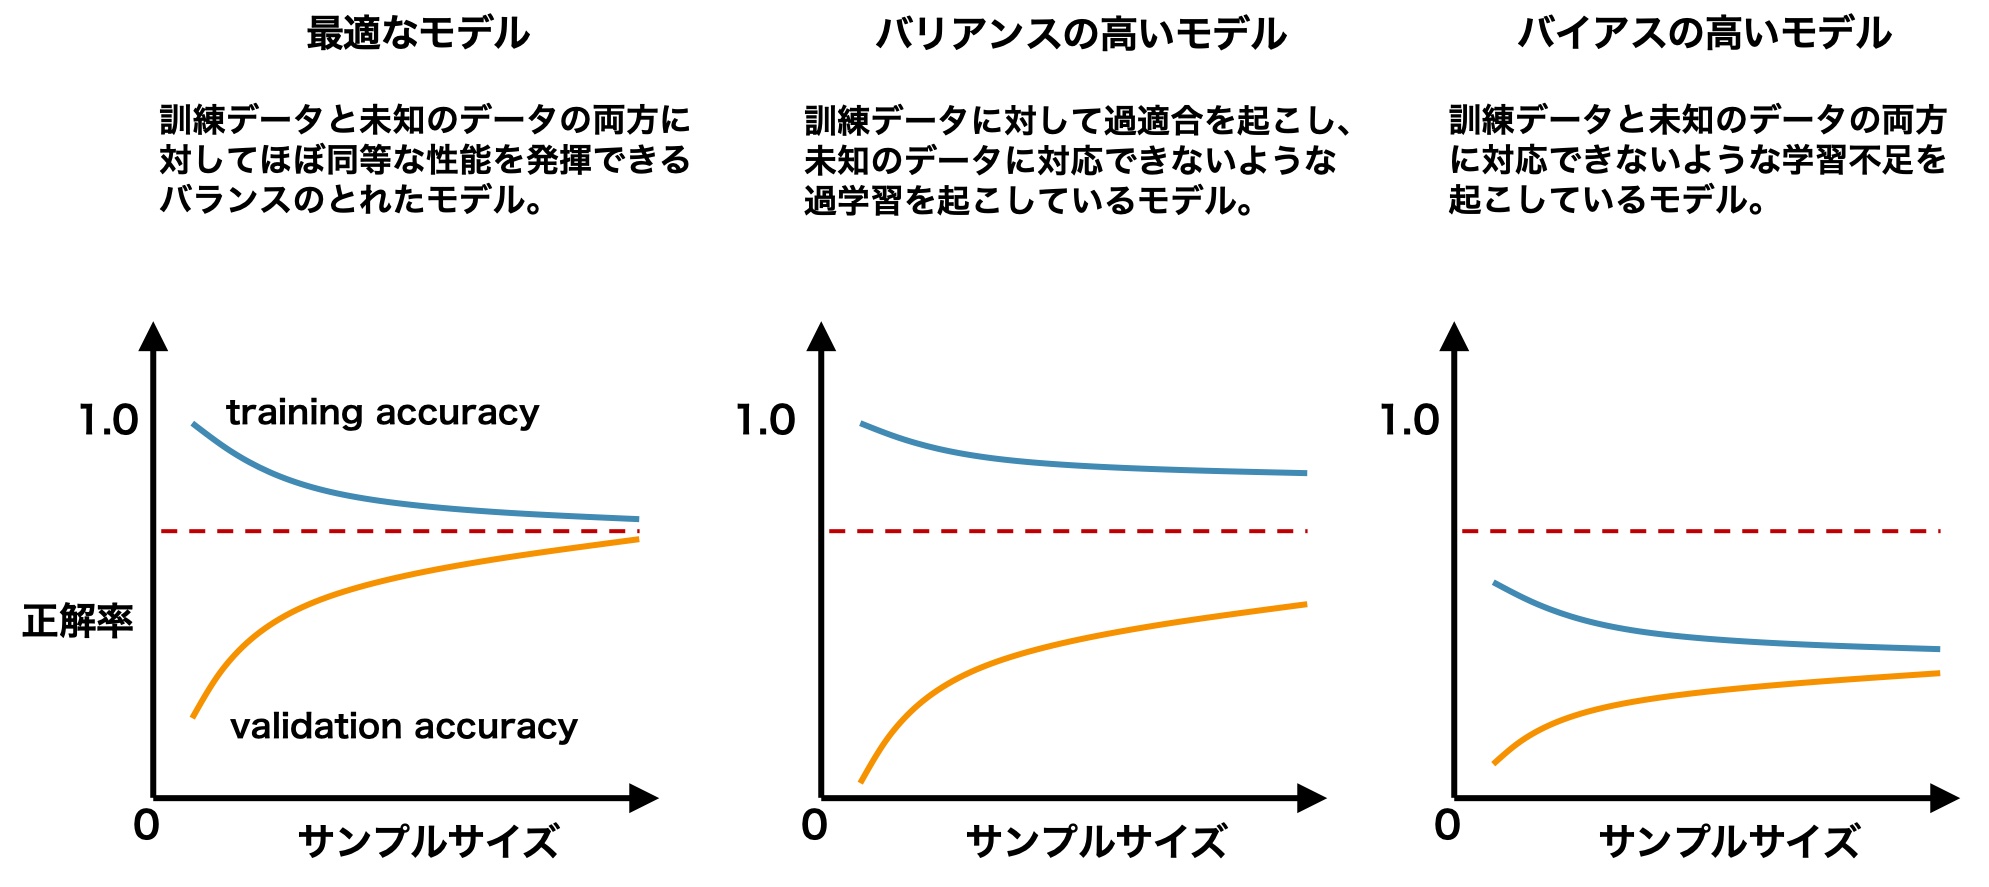
  • モデルの状態

モデルの状態

学習不足(高バイアス)状態への対応​
  • モデルの特徴量を増やす。アルゴリズム自体を変更するなどの対策が考えられます。
過学習状態への対応​
  • データを増やしトレーニングを行うことで解消されます。

いずれの状態にしても一旦データ量を増やし正答率をチェックすることで、現在の状況を把握することが必要です。

2-5. 具体的な運用フロー​

上記の機械学習モデルの一般的なライフサイクルに則って運用を定期的に行います。

  1. 定期的に学習用データを集める
  2. データが集まったタイミングで交差検証(モデルの学習用に使うデータを、学習用に使う「訓練データ」とモデルの性能を評価のために使う「検証データ」の2つに分けることで過学習を防ぐ方法。一般的には訓練データ7 : 検証データ3の割合。)によりモデルのトレーニングを行います。
  3. Lobeで行うのではなく、WEBRAL側で用意する管理サイト上(最初はGoogle Drive)で画像のアップロードとラベリング作業を行なって頂きます。
  4. ラベリング作業完了次第、生成された各モデルの評価検証を管理サイト上(最初はスプレッドシート)で行います。(このタイミングでお打ち合わせ)
    • お打ち合わせでは、各モデルの正答率の確認と改善が必要なモデルの洗い出しなどを行います。
  5. 生成された機械学習モデルをモデル診断カルテに反映します。
  • 補足事項
    • 機械学習モデル管理用ページを作成することで、ラベリング作業にのみ集中頂ける状況を作ります。
    • 現在までにLobeでトレーニング頂いたものは一旦こちらに移行します。

2-6. 作業内容​

  • プロモデルスタジオ
    • ラベリング作業(ただしLobeは使用せず、管理サイト上(最初はGoogle Drive)で行う)
  • WEBRAL
    • モデルの生成(最初はLobe。モデルの状況によって別のソフトを利用。)
    • モデルの評価作業(最初はスプレッドシート)
    • モデルのデプロイ(=モデル診断カルテに反映)
    • お打ち合わせ

2-7. スケジュールと期間​

  • データが集まったタイミングで都度、上記のフローを実施。

2-8. 料金​

要相談。都度作業時間に応じてご請求。

  • 都度の作業時間イメージ
    • モデルの生成・・・10〜20分×20モデル=約3〜4時間
    • モデルの評価作業・・・10〜20分×20モデル=約3〜4時間
    • モデルのデプロイ・・・3分×20モデル=約1時間
    • お打ち合わせ・・・約1〜2時間

おおよそ5〜11時間 => 約3〜7.5万(税込)?

参考サイト​


3. 本日の決定事項やTODO​

参加者​

武田様、山森様、宮森様、戸張

議題​

  1. 前回の議論
  2. 気になる箇所
  3. 本日の決定事項やTODO

1. 前回の議論​

  • 「顔立ち」の採点結果が低く算出されてしまう問題

    • [現象]
      • 加点方式のため点数が上がりづらく、また「先天的要因」による減点が目立つ
    • [対応]
      1. 「先天的要因」に関する機械学習モデルのデータ量を増やし精度を高める
      2. 「顔立ち」に関する採点方法の見直し(コマーシャルモデル・ファッションモデルで採点基準を統一。減点を-3から-1に変更)
  • 芸能事務所の抽出方法の見直し(ロジック)

    • [問題点]
      • 芸能事務所の場合ビジュアルだけで差別化を図るのが難しい
    • [対応]
      1. 「おすすめのモデルカテゴリー」で算出されたモデルカテゴリーに紐付いた「事務所の分類(総合エンタメ・清楚系など)」の中から、総合得点の近い事務所5件を抽出する
  • 受け入れ年齢・身長の設定

    • [問題点]
      • 全事務所ごとに受入年齢・身長を設定するのが難しい
    • [対応]
      • 各事務所ごとに設定するのではなく、事務所の分類(総合エンタメ・清楚系など)ごとで設定しておく
  • カルテ確認


2. 気になる箇所​

  • あなたにおすすめのモデルカテゴリーで「モード系ファッションモデル」の出現率が高い(8/10)
    • 算出方法→応募者のファッションモデルスコアとコマーシャルモデルスコアの得点表と全モデルカテゴリーの得点表の相関係数を求め相関の高い(相関係数 0〜1)モデルカテゴリーを一つ選出
      • 対応→各モデルカテゴリーの点数を調整(差をもう少し広げてみたり狭めたりなど)(管理画面で調整可能)
  • おすすめのモデル事務所で、「詳しく見る」で事務所のHPに遷移する仕様にしているが、所属タレントの画像も頂いているので、モデル画像も見せつつリンクも表示する形にした方がよろしいでしょうか?
  • 画像解析が難しいケースがある。(全身画像で股下の高さが見えない画像など)
    • 対応→画像の撮り方を極力統一するなど

3. 本日の決定事項やTODO​

参加者​

山森様、戸張

議題​

  1. 検討事項
  2. 確認事項
  3. 本日の決定事項やTODO

1. 検討事項​

■ おすすめの芸能事務所の選定方法 [結論] → 芸能事務所ごとに予め総合得点を設定しておき、応募者の総合得点に近い得点の事務所を表示するようにする。 → スプレッドシートの修正(芸能事務所の場合は総合得点を入力する) → 管理画面のどこかで応募者の総合得点を見れるようにする(芸能事務所の総合得点の基準を知るために)

■ コマーシャルモデルの採点ロジックに関する質問

  • 全身のバランスの件(B82-88とありますが、B81とB80は1点減点、B79は2点減点という解釈でよろしかったでしょうか?)
  • 足の形(機械学習モデルに「真っ直ぐ」のラベルを追加しLobeで再度トレーニングが必要)
  • 顔立ちの採点で、卵型が二つになっている?
  • 顔立ち、CMでは4タイプに分類するが、FMでは5タイプに分類。なので、コマーシャルモデル用の顔立ちの分類用の機械学習モデルが必要?
  • 鼻の大きさの選択肢で「丸い」?

2. 確認事項​

  • マスターデータのご準備
    • 事務所情報のご準備
    • 事務所のモデル画像のご準備

3. 本日の決定事項やTODO​

  • コマーシャルモデルの顔立ちの採点方法の見直し
    • 輪郭をファッションモデルの選択肢と合わせる。鼻の大きさ「丸い」を修正
    • 先天的要因のマイナスの幅を狭める(-3→-1?)に変更
  • コマーシャルモデルの笑顔の「出っ歯」と「受け口」の減点を-4から-3に変更
  • 脚の形の学習モデルを再度ご提出

参加者​

武田様、山森様、宮森様、戸張

議題​

  1. 検討事項
  2. 確認事項
  3. 本日の決定事項やTODO

1. 検討事項​

  • 主観的評価と実際の採点結果の乖離について

    • 主に、顔立ちが低く算出されてしまう問題
      • [要因]
        • 「先天的要因」による減点が目立つことと、加点方法も確率的にやや厳しいことが考えられます。
      • [対応案]
        1. 「先天的要因」に関する機械学習モデルのデータ量を増やし精度を高める
        2. 「顔立ち」に関する採点方法の見直し
  • 芸能事務所のレコメンド表示について

    • 芸能事務所の表示方法(デザイン、ロジック)
      • デザインは、「他候補の事務所」と同様に事務所名とボタン?
      • ロジックは、
        1. 既存の「身長」「全身バランス」「脚の形」「顔立ち」「肌質」「年齢」で芸能事務所も算出する
        2. 上記の採点項目以外の項目「人間性?」とかも随時入力するようにする
        3. モデルカテゴリーと紐づける

2. 確認事項​

  • マスターデータのご準備
    • モデルカテゴリーのご準備
    • モデルカテゴリー画像のご準備
    • 事務所情報のご準備
    • 事務所のモデル画像のご準備
    • -各項目ごとのアドバイス・改善点文言-

3. 本日の決定事項やTODO​

参加者​

武田様、山森様、宮森様、戸張

議題​

  1. 残タスクについて
  2. 登録フローの確認
  3. 確認事項
  4. 本日の決定事項やTODO

1. 残タスクについて​

  • 画像の自動解析
  • 類似モデルカテゴリー・事務所の算出
  • 細かい見た目の調整
    • 1440px以上の大画面パソコン時のフォントサイズ調整など

2. 登録フローの確認​

https://azukari-agent.app.webral.dev/

ID: info@azukariagent.com
パスワード: azukari123123


3. 確認事項​

  • 採点項目についての確認
  • ラベリング作業について
    • 以下の項目に関しまして「該当なし」の選択肢を追加し再度ご提出をお願いしたく、、申し訳ございません。
      • 脚のバランス
      • 先天的要因
      • 鼻の形(正面)
      • 鼻の形(横向き)
      • 肌質
      • 歯の特徴
      • 笑顔の形
  • 機械学習モデルを作成するか自動計算をするか
    • スプレッドシート
      • 鼻筋(細い・普通・太い)
      • 鼻の大きさ(小さい・普通・大きい)
      • 唇の厚さ(小さい・普通・大きい)
      • 口の大きさ(小さい・普通・大きい)
    • 各項目をLobeを使わずに20件ほど分類をお願いしたく存じます。。(フォルダに分けて入れる等で構いません。)
  • マスターデータのご準備
    • モデルカテゴリーのご準備
    • 事務所情報のご準備
    • モデル画像のご準備
    • 各項目ごとのアドバイス・改善点文言

4. 本日の決定事項やTODO​

  • 今後の進め方について
    • 再びのラベリング作業を優先とし、マスターデータのご準備が終わったタイミングで最終のお打ち合わせという形で如何でしょうか。

参加者​

武田様、山森様、宮森様、戸張

議題​

  1. 残タスクについて
  2. 登録フローの確認
  3. その他の確認事項
  4. ラベリング作業のレクチャー
  5. 本日の決定事項やTODO

1. 残タスクについて​

  • モデル診断カルテページ
    • デザイン改修
    • アニメーションの参考サイトを探す
  • 画像登録時の自動画像解析
  • 採点機能
  • 採点結果を元におすすめのモデルカテゴリーとおすすめの事務所の算出

2. 登録フローの確認​

https://azukari-agent.app.webral.dev/

ID: info@azukariagent.com
パスワード: azukari123123


3. その他の確認事項​

  • 応募者画像解析による自動計算について
  • モデルカテゴリーのご準備(カテゴリー名、あなたの傾向の文章)
  • 事務所のご準備(事務所名、所在地、最小年齢、最大年齢、最小身長、最大身長)
  • モデル画像のご準備
  • ドメインに関して
    • azukari.promodelstudio.com

4. 本日の決定事項やTODO​

  • リリース当初は、azukari.promodelstudio.com みたいなpromodelstudio.comのサブドメインで運用
  • ロゴも最初はPROMODELSTUDIO にしておき、来年以降でazukariに戻す
  • アニメーションを凝るのはリリース以降で。今付けれる範囲で簡易的につけよう。